Faire tourner votre cloud en local avec Floci
Floci est une nouvelle pépite open source qui permet de faire tourner vos environnements cloud propriétaires AWS, Google Cloud et Azure sur votre poste.
Floci est un émulateur de services cloud qui se veut complètement gratuit et multi-cloud. Il permet de faire tourner n’importe quel service AWS, Google Cloud ou Azure dans un unique conteneur Docker. Une URL unique permet d’accéder aux services cloud depuis son environnement local. On peut ainsi tester son infrastructure avant de la déployer.
Cerise sur le gâteau, cet environnement est gratuit, sans restriction et open source !
Je l’utilise pour émuler les services AWS depuis plusieurs mois déjà.
À date, je n’ai pas encore pu le tester dans mes projets sur d’autres Cloud Providers, cet article va surtout parler de son usage dans un environnement AWS.
Floci un remplaçant sérieux à LocalStack
Auparavant, si on voulait émuler une technologie cloud, il fallait passer par LocalStack. C’est exactement le même principe, sauf que tous les services ne sont pas disponibles. Ainsi, seuls 30 services AWS sont gratuits. Il n’y a pas de version gratuite pour les autres. Par exemple, si vous voulez gérer votre authentification avec AWS Cognito, le service n’est pas dans le free tier. Il vous faut donc une licence payante.
De plus, LocalStack a récemment durci les conditions d’utilisation de sa licence gratuite, qui ne permet plus que de l’utiliser sur des projets non-commerciaux.
Un concurrent n’a pas tardé à voir le jour, son petit nom est Floci ! Aucune restriction, complètement open-source, beaucoup plus rapide que son conccurent. Ça marche vraiment très bien !
Ça s’installe comment ?
En CLI:
curl -fsSL https://floci.io/install.sh | sh
floci start
Avec Docker:
services:
  floci:
    image: floci/floci:latest
    ports:
      - "4566:4566"
    volumes:
      # Local directory bind mount (default)
      - ./data:/app/data
L’URL utilisera souvent le port 4566, qui est en fait le même que celui de LocalStack.
Floci est lancé ; il ne reste plus qu’à configurer AWS CLI pour rediriger ses appels vers l’environnement local
export AWS_ENDPOINT_URL=http://localhost:4566
export AWS_DEFAULT_REGION=us-east-1
export AWS_ACCESS_KEY_ID=test
export AWS_SECRET_ACCESS_KEY=test
L’Access key peut être absolument n’importe quoi, tant que l’URL est bonne.
On peut ensuite lancer des commandes CLI.
# S3 — create a bucket and upload a file
aws s3 mb s3://my-bucket --endpoint-url $AWS_ENDPOINT_URL
echo "hello floci" | aws s3 cp - s3://my-bucket/hello.txt --endpoint-url $AWS_ENDPOINT_URL
aws s3 ls s3://my-bucket --endpoint-url $AWS_ENDPOINT_URL
Dans un projet, il suffit d’importer les mêmes variables d’environnement. Le SDK AWS enverra alors ses appels à Floci plutôt qu’à AWS. Floci se veut “Drop-in replacement”, on change un paramètre, on a switché. Et ça c’est super pratique !
On peut tout émuler ?
Absolument tout, que ce soit vos Lambdas, vos logs CloudWatch, vos appels à Bedrock ou à tout autre service implémentant du machine learning. 100% des services AWS sont couverts. Il y a également un support très large sur Google Cloud, Azure et Oracle Cloud. Bien qu’il ne soit pas complet pour les 3 derniers, la liste s’étoffe très rapidement.
Pour les services tels que Textract (Extraction de texte), Translate, ou Bedrock, les appels API fonctionnent, mais le traitement ne fournis pas le résultat attendu. Par exemple pour Translate, la chaîne traduite par le service ne l’est pas vraiment, c’est la chaîne d’entrée qui est retournée.
Ça marche en Infra-As-Code ?
Absolument ! Pour AWS CDK : Il suffit d’utiliser cdklocal, développé initialement pour LocalStack. Sinon, surchargez simplement l’AWS Endpoint URL
Pour Terraform :
Définissez dans votre provider.tf vos URL par service :
terraform {
  required_providers {
    aws = {
      source  = "hashicorp/aws"
      version = "~> 6.0"
    }
  }
}

provider "aws" {
  region     = "us-east-1"
  access_key = "test"
  secret_key = "test"

  skip_credentials_validation = true
  skip_metadata_api_check     = true
  skip_requesting_account_id  = true
  s3_use_path_style           = true

  endpoints {
    dynamodb       = "http://localhost:4566"
    s3             = "http://localhost:4566"
    sqs            = "http://localhost:4566"
  }
}
Pour Pulumi : Il faut là aussi définir une URL par service.
config:
  aws:region: us-east-1
  aws:s3UsePathStyle: "true"
  aws:skipCredentialsValidation: "true"
  aws:skipMetadataApiCheck: "true"
  aws:skipRequestingAccountId: "true"
  aws:endpoints:
    - s3: http://localhost:4566
      dynamodb: http://localhost:4566
      sqs: http://localhost:4566
Mais, il y a un mais ?
J’ai noté 2 points perfectibles dans l’outil :
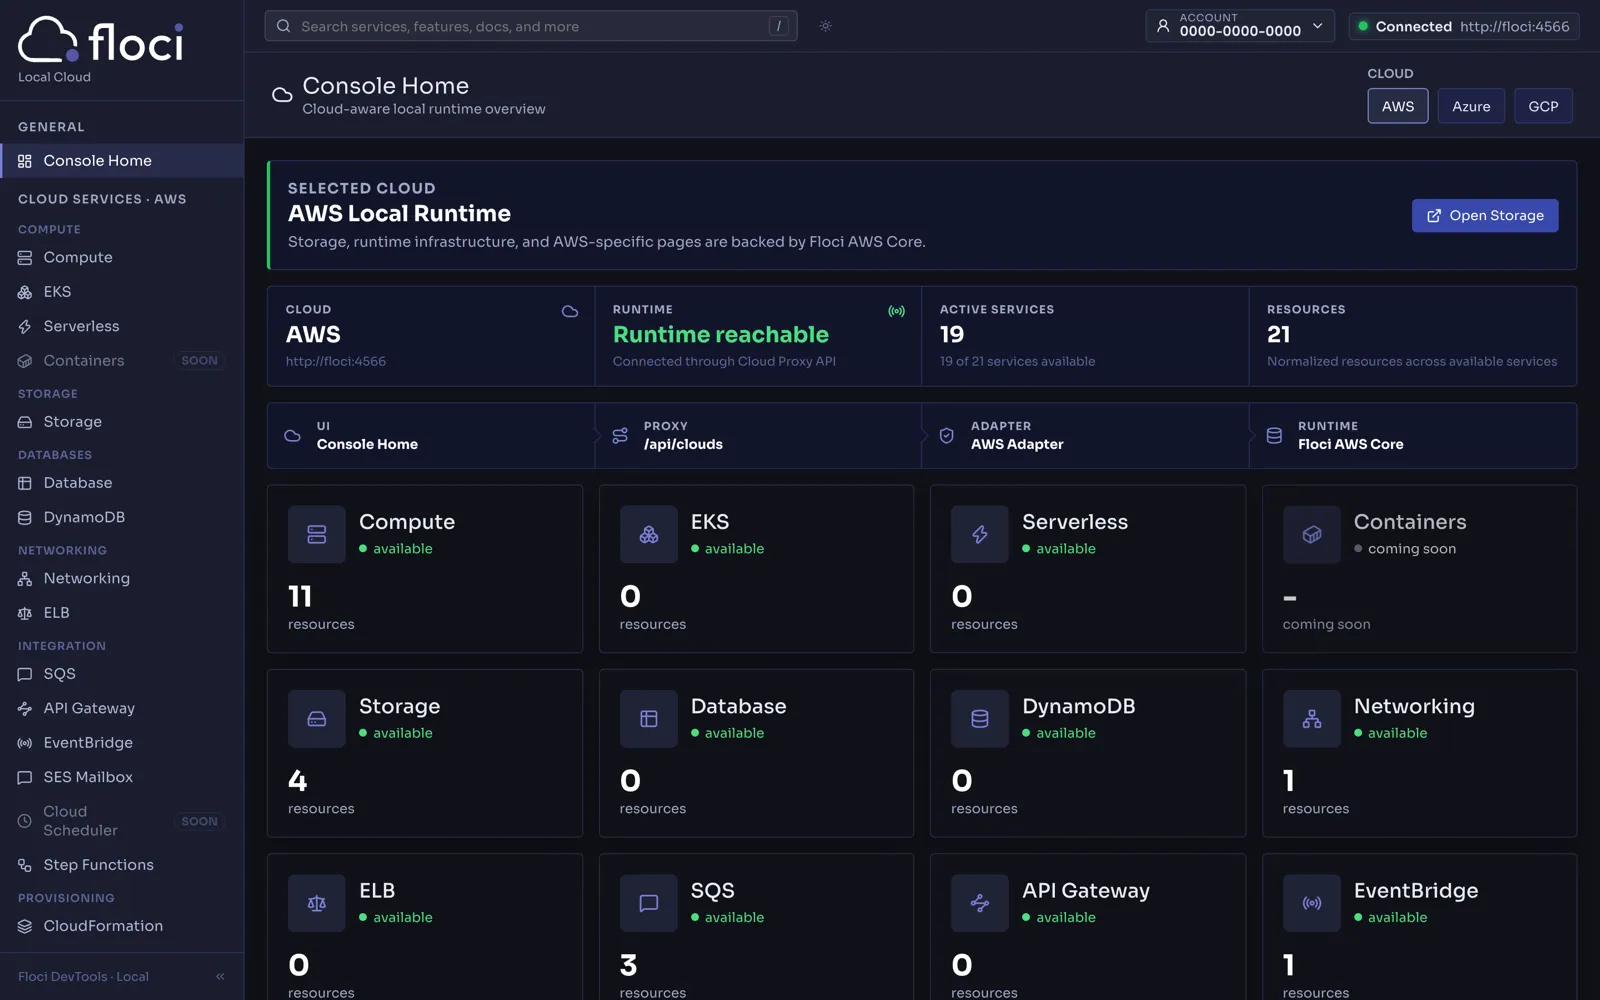
Pas de console locale
Même si Floci UI est en cours de développement, le projet n’est pas vraiment utilisable en l’état, mais c’est dans la boîte ! Pour l’avoir testé en clonant le repo, c’est très prometteur et ça avance quand même vite.
Duplication de ressources avec CloudFormation
Si vous déployez à l’aide d’AWS CDK ou CloudFormation, certaines ressources telles qu’API Gateway ou Cognito ne sont pas correctement tracées. Ainsi, à chaque déploiement, l’émulation de CloudFormation va recréer une nouvelle ressource plutôt que d’éditer la ressource existante. Ça signifie que côté frontend, l’URL de votre Cognito ou de votre API Gateway va changer !
Pour contourner ce problème, nous avons ajouté un utilitaire à la configuration de Vite. Il récupère les ressources API Gateway et Cognito les plus récentes, puis les définit comme variables d’environnement.
import { execSync } from "node:child_process"
import { reactRouter } from "@react-router/dev/vite"
import { defineConfig } from "vite"

function getLocalApiTarget() {
  const apiId = execSync(
    'AWS_ACCESS_KEY_ID=test AWS_SECRET_ACCESS_KEY=test aws apigateway get-rest-apis --endpoint-url http://localhost:4566 --region ca-central-1 --query "sort_by(items, &createdDate)[-1].id" --output text',
    { encoding: "utf-8" },
  ).trim()
  return `http://localhost:4566/restapis/${apiId}/prod/_user_request_/api`
}

function getLocalCognitoConfig() {
  const userPoolId = execSync(
    'AWS_ACCESS_KEY_ID=test AWS_SECRET_ACCESS_KEY=test aws cognito-idp list-user-pools --max-results 1 --endpoint-url http://localhost:4566 --region ca-central-1 --query "UserPools[-1].Id" --output text',
    { encoding: "utf-8" },
  ).trim()

  const userPoolClientId = execSync(
    `AWS_ACCESS_KEY_ID=test AWS_SECRET_ACCESS_KEY=test aws cognito-idp list-user-pool-clients --user-pool-id ${userPoolId} --endpoint-url http://localhost:4566 --region ca-central-1 --query "UserPoolClients[0].ClientId" --output text`,
    { encoding: "utf-8" },
  ).trim()

  return { userPoolClientId, userPoolId }
}

function getLocalEnvDefines() {
  if (process.env.VITE_ENV !== "local") {
    return {}
  }

  const { userPoolId, userPoolClientId } = getLocalCognitoConfig()
  const apiURL = getLocalApiTarget()

  return {
    "import.meta.env.VITE_API_GATEWAY_URL": JSON.stringify(apiURL),
    "import.meta.env.VITE_USER_POOL_CLIENT_ID":
      JSON.stringify(userPoolClientId),
    "import.meta.env.VITE_USER_POOL_ID": JSON.stringify(userPoolId),
  }
}

export default defineConfig({
  //...
  define: getLocalEnvDefines(),
})
Conclusion
Pouvoir tester en local son infra plutôt que de déployer à chaque micro-changement, c’est une bouffée d’air frais pour moi.
On l’utilise déjà dans de nombreux projets, dont certains avec une architecture vraiment très complexe.
La mise en place a vraiment été sans accroc, tout en Infra-As-Code. C’est un vrai gain de temps dans notre quotidien !
On peut déplorer pour l’instant l’absence d’interface pour naviguer dans les services.
C’est d’ailleurs pour ça que j’ai développé LambdaLogsViewer, qui permet de naviguer parmi les récents appels de nos lambdas. C’est très utile en dev comme en local !